새 AI 모델이 나오면 아레나 리더보드부터 찾아보게 됩니다. 여러 모델을 한눈에 비교할 수 있어 편하지만, 순위가 높은 모델을 곧바로 “가장 똑똑한 모델”로 받아들이기 쉽습니다.
그런데 아레나 점수는 정답 개수를 세어 만든 성적표가 아닙니다. Chatbot Arena 공식 논문을 보면 사용자는 같은 질문에 답한 두 익명 모델을 나란히 보고 더 마음에 드는 답변을 고릅니다. 이렇게 모인 쌍대 비교 결과를 Bradley-Terry 통계 모델로 집계해 상대적인 선호 점수를 만듭니다.
아레나가 직접 측정하는 것은 결국 “이 답변이 다른 답변보다 선택됐는가”입니다. 사실이 정확한지, 계산이 맞는지, 코드가 실제로 실행되는지만 따로 채점하지는 않습니다. 정확성도 선택에 영향을 주지만 설명의 친절함, 답변 길이, 문장 구성, 마크다운 형식도 함께 작용합니다.
아레나는 답변 선호를 비교합니다. 글의 이미지는 ChatGPT로 만든 개념 설명 그림이며 실제 순위표나 측정 결과가 아닙니다.
선호도가 높으면 능력도 높은 걸까요?
둘은 관련이 있지만 같은 뜻은 아닙니다. 보기 좋고 이해하기 쉬운 답변도 분명 중요한 능력입니다. 고객 상담이나 글쓰기처럼 사람이 결과물을 직접 읽는 작업에서는 사용자 선호가 꽤 실용적인 평가 기준이 될 수 있습니다.
하지만 회계 수치 확인, 기술 문서 검토, 코드 오류 탐지처럼 틀린 답 하나의 비용이 큰 작업이라면 선호도만으로는 부족합니다. 그럴듯하고 자세한 오답이 짧고 정확한 답보다 더 좋아 보일 수도 있기 때문입니다.
Arena 연구팀의 스타일 통제 분석에서도 답변 길이와 마크다운 요소를 통제하자 일부 순위가 달라졌습니다. 특히 길이의 영향이 컸습니다. 다만 관찰 연구인 만큼 긴 답변이 단순히 장황한 것인지, 실제로 더 충실한 추론을 담았는지까지 완전히 나누지는 못했습니다.
그래서 아레나는 “사람들이 실제 대화에서 어떤 답을 더 좋아했는가”를 살펴보는 자료로 읽는 편이 맞습니다. 객관적인 정답 능력 전체를 한 숫자로 압축한 표로 보기에는 무리가 있습니다.
리더보드에서는 무엇부터 봐야 할까요?
먼저 카테고리를 확인해 보세요. 현재 Text Arena는 수학, 코딩, 창작, 지시 이행 등 성격이 다른 질문을 다룹니다. 공식 논문도 모델 간 격차가 주제에 따라 달라질 수 있다고 설명합니다. 전체 점수는 여러 종류의 질문을 섞은 결과입니다. 코드 리뷰가 목적이라면 전체 순위보다 코딩 관련 결과가 더 가깝습니다. 한국어 보고서를 쓰려는 경우에는 공개 평가의 언어와 작업 조건이 내 업무와 얼마나 닮았는지도 따져봐야 합니다.
모델 이름도 끝까지 읽어야 합니다. 같은 제품군이라도 출시 시점, 추론 강도, 컨텍스트 설정에 따라 별도 항목으로 표시됩니다. 회사 이름끼리 뭉뚱그려 비교하지 말고, 실제로 사용할 모델 ID와 설정이 표의 항목과 같은지 확인하는 편이 좋습니다. API와 채팅 서비스의 모델이나 기본 설정이 다르다면 점수를 그대로 적용하기 어렵습니다.
점수 옆의 불확실성 표시도 빼놓을 수 없습니다. 현재 표에는 오차 범위, 투표 수, rank spread가 함께 나옵니다. 점수가 조금 높아도 범위가 크게 겹친다면 확실한 우위라고 말하기 어렵습니다. 새로 들어왔거나 표본이 적은 모델은 순위 숫자보다 불확실성을 먼저 보세요. 특정 날짜의 1위를 장기적인 능력 서열로 굳히지 말아야 하는 이유입니다.
독립적인 비판도 참고할 만합니다. 2025년 NeurIPS에 실린 The Leaderboard Illusion은 2024년 1월부터 2025년 4월까지의 자료를 분석해 비공개 모델 변형의 선택적 공개, 공급자별 샘플링과 모델 제외 정책 차이를 지적했습니다. 당시에는 리더보드가 만들어지는 과정도 결과에 영향을 줄 수 있었다는 역사적 경고입니다. 이후 정책이 바뀌었을 수 있으므로, 이 연구만으로 2026년 현재도 같은 문제가 이어진다고 단정해서는 안 됩니다.
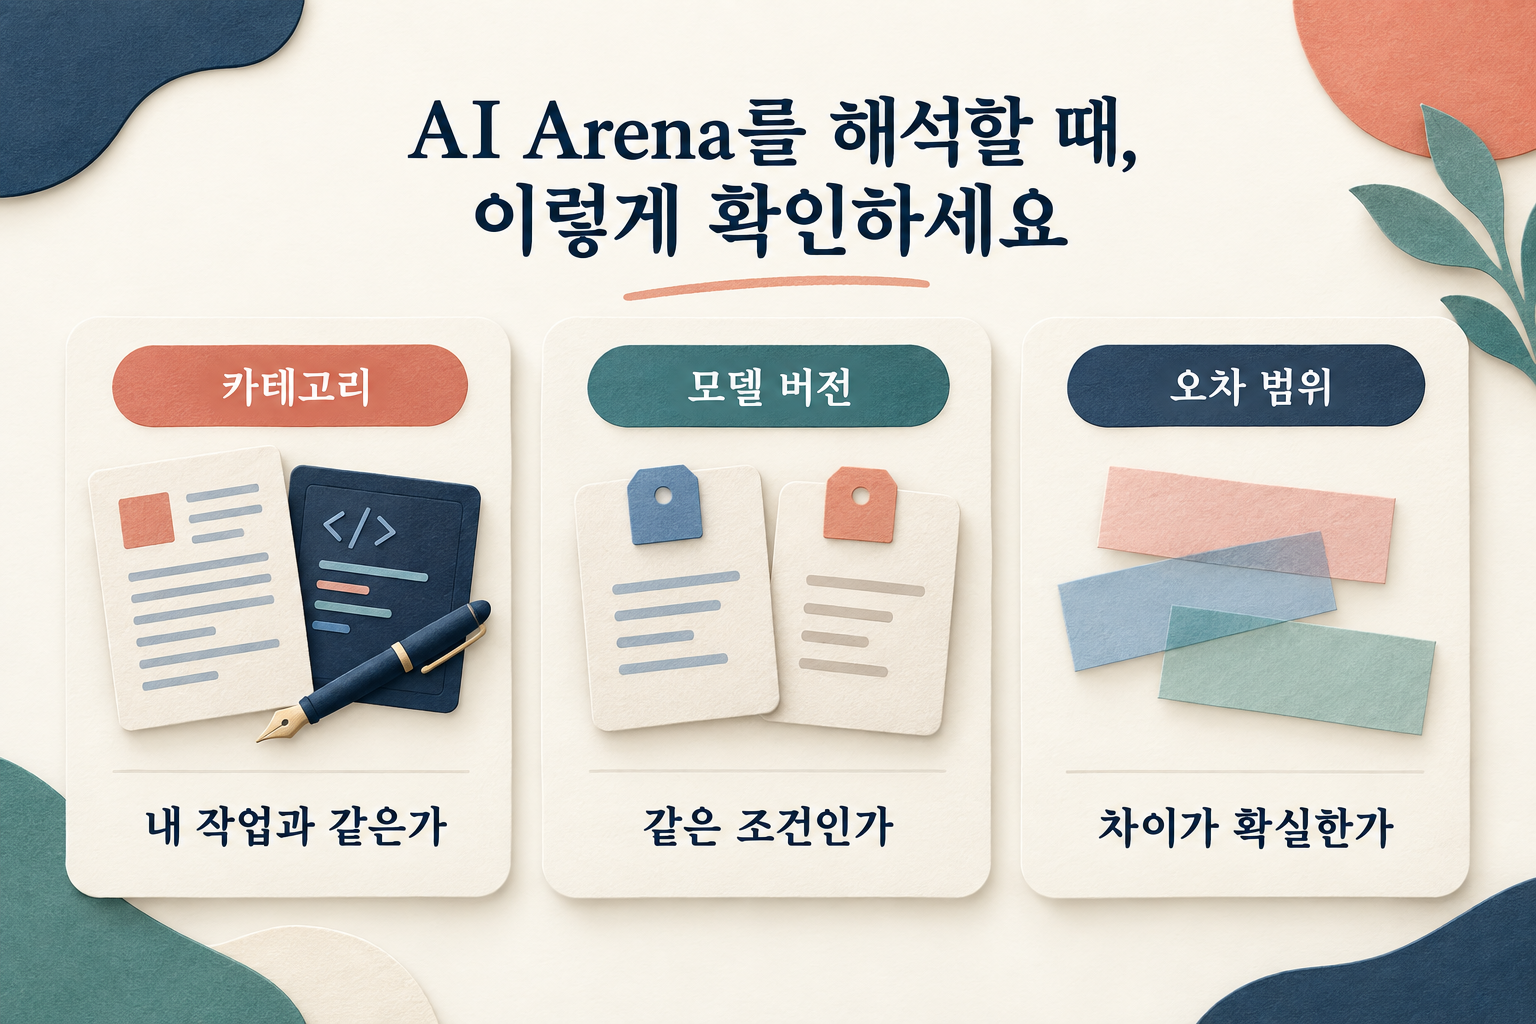
전체 순위보다 업무 분야, 정확한 모델 버전, 점수의 불확실성을 먼저 확인해 보세요.
싼 모델과 빠른 모델은 다릅니다
실제 도입 단계에서는 순위뿐 아니라 가격과 속도도 봐야 합니다. 여기서 “백만 토큰당 얼마”만 비교하면 중요한 차이를 놓칠 수 있습니다. Artificial Analysis 방법론은 입력·출력 가격과 함께 첫 토큰이 오는 시간, 첫 답변 토큰까지의 시간, 출력 속도, 전체 응답 시간, 과업당 비용을 따로 구분합니다.
사용자가 화면을 보며 기다리는 상담 업무라면 첫 응답 속도가 중요합니다. 긴 문서를 만드는 작업은 첫 토큰보다 전체 완료 시간과 출력 속도가 더 중요할 수 있습니다. 대량 자동화에서는 답변이 길어질수록 같은 토큰 단가라도 과업당 비용이 커집니다. 추론 토큰과 대기 시간까지 포함해 봐야 실제 비용에 가까워집니다.
업무에 따라 선택 기준도 이렇게 달라집니다.
- 보고서 작성에서는 생성 속도보다 근거 보존, 숫자 오류, 출처 처리, 수정 횟수를 먼저 봅니다. 초안이 조금 늦더라도 검수 시간을 줄여준다면 더 나은 선택일 수 있습니다.
- 코드 리뷰에서는 실행 가능한 지적, 허위 경고, 테스트 실패 원인 파악을 확인합니다. 저렴해 보여도 사람이 여러 번 다시 검토해야 한다면 그 시간까지 비용에 넣어야 합니다.
- 대량 요약에서는 문서 누락과 환각을 먼저 걸러낸 뒤 전체 처리 시간과 문서 한 건당 비용을 비교합니다. 이 작업에서는 첫 토큰 속도가 상대적으로 덜 중요할 수 있습니다.
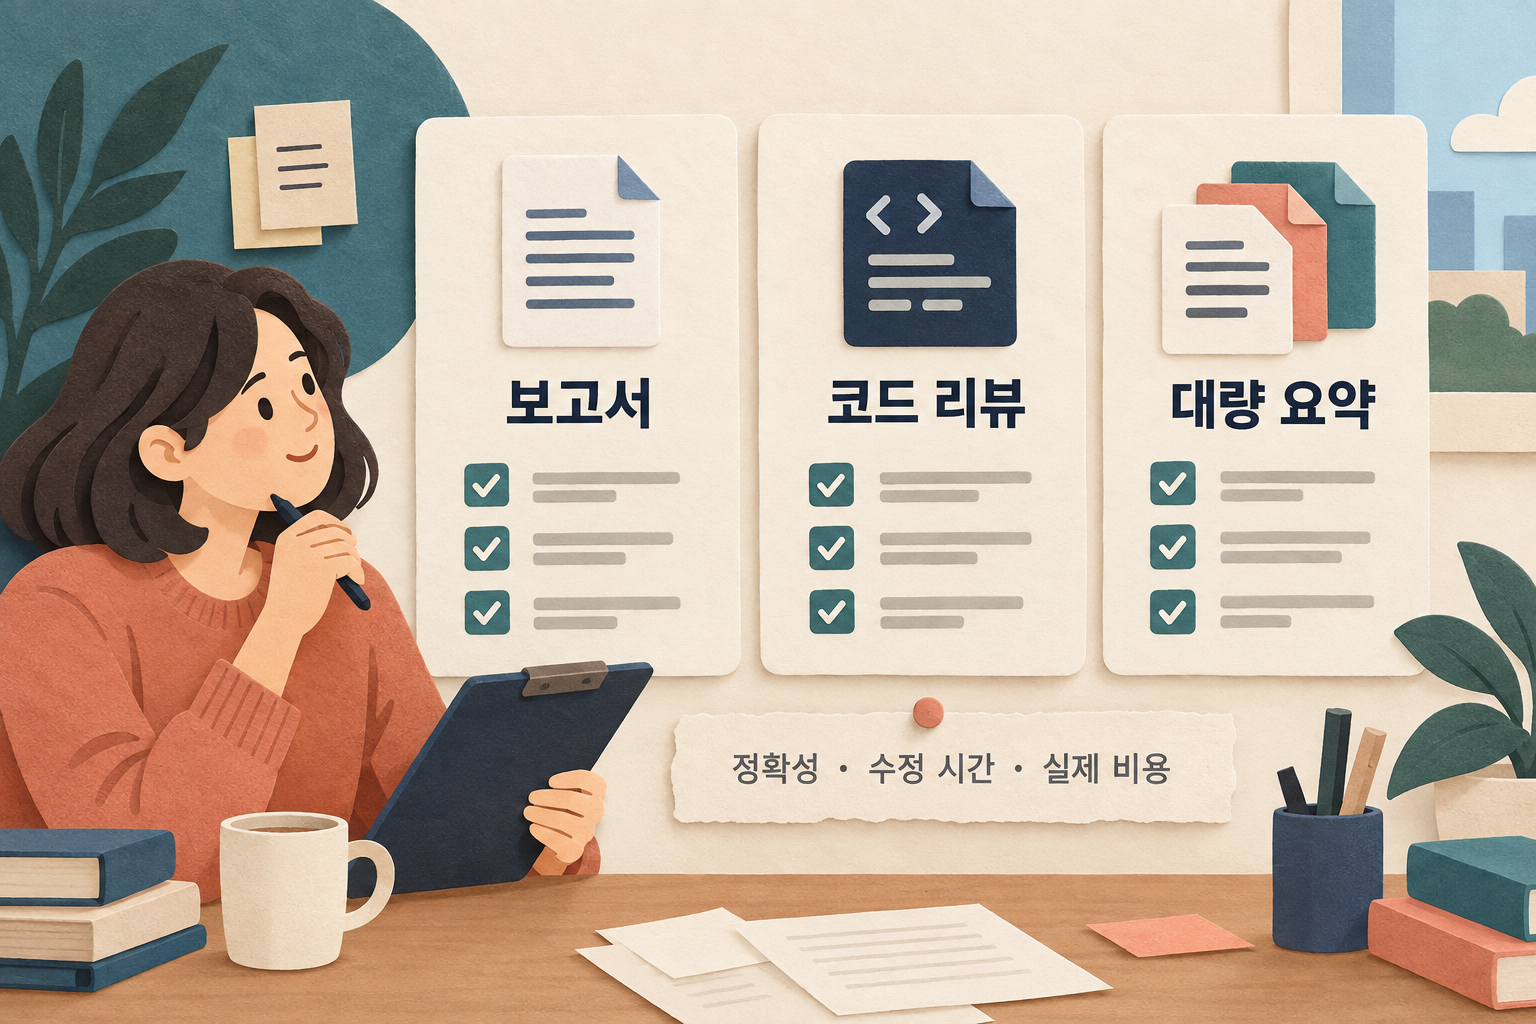
보고서·코드 리뷰·대량 요약처럼 실제로 반복할 작업에서 수정 시간과 과업당 비용을 함께 기록하세요.
세 가지 작업으로 작게 비교해 보세요
거창한 사내 벤치마크부터 만들 필요는 없습니다. 실제로 자주 맡길 작업 세 개를 골라 후보 모델에 같은 조건으로 요청해 보면 됩니다.
- 보고서 작업: 원문 두 개를 주고 핵심 수치와 출처를 유지한 1쪽 요약을 작성하게 합니다.
- 코드 리뷰 작업: 의도적으로 버그를 넣은 짧은 변경 사항에서 문제와 수정안을 찾게 합니다.
- 대량 요약 작업: 형식이 다른 여러 문서를 같은 항목의 표로 정리하게 합니다.
결과를 볼 때는 정확성, 누락·환각, 사람의 수정 시간, 전체 완료 시간, 실제 과업당 비용을 기록해 보세요. 모델명은 가리고 결과부터 평가하면 브랜드 선입견도 줄일 수 있습니다. 한국어 표현과 사내 형식 준수 여부까지 더하면 공개 리더보드보다 내 업무에 가까운 비교표가 나옵니다.
아레나 순위는 후보를 줄이는 데 유용하지만 최종 선택표는 아닙니다. 업무 카테고리와 정확한 버전, 점수의 불확실성을 확인한 뒤 실제 작업 한 건의 시간과 비용, 틀렸을 때의 손실까지 비교해야 합니다.
결국 중요한 질문은 “지금 1위가 누구인가”가 아닙니다. “내가 반복해서 맡길 이 일에서, 어느 모델이 가장 적은 수정과 비용으로 필요한 결과를 내는가”입니다.
출처 및 확인일
- Arena Intelligence, “LLM Leaderboard - Best Text & Chat AI Models Compared”, 표 갱신일 2026-10-02, https://arena.ai/leaderboard/text 확인일: 2026-10-03
- Chiang et al., arXiv / ICML 2024, “Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference”, arXiv 최초 제출 2024-03-07, https://arxiv.org/abs/2403.04132 확인일: 2026-10-03
- LMSYS Org, “Does style matter? Disentangling style and substance in Chatbot Arena”, 2024-08-28, https://www.lmsys.org/blog/2024-08-28-style-control/ 확인일: 2026-10-03
- Singh et al., NeurIPS 2025 Datasets and Benchmarks Track, “The Leaderboard Illusion”, 페이지 게시일 표시 없음, https://proceedings.neurips.cc/paper_files/paper/2025/hash/70a93f260a51123b3c0e33ecd1b4de97-Abstract-Datasets_and_Benchmarks_Track.html 확인일: 2026-10-03
- Artificial Analysis, “Artificial Analysis Benchmarking Methodology”, 페이지 게시일 표시 없음, https://artificialanalysis.ai/methodology 확인일: 2026-10-03
'💻IT' 카테고리의 다른 글
| ChatGPT dots 설정법: 상시 에이전트에 맡기기 전 권한 체크리스트 (0) | 2026.10.06 |
|---|---|
| Codex CLI 음성·병렬 에이전트, 권한부터 잡는 운영 가이드 (0) | 2026.10.05 |
| ChatGPT 가상 피팅 써도 될까? 사진 삭제·핏 확인 체크리스트 (0) | 2026.10.05 |
| Claude Skills와 MCP, 둘 중 무엇부터 써야 할까? (0) | 2026.10.04 |
| ChatGPT 프로젝트 사용법: 지침·자료·대화 정리 기준 (0) | 2026.10.03 |

