Claude Sonnet 5.5는 “Opus보다 무조건 아래인 저가형 모델”로만 보면 선택을 잘못하기 쉽습니다. Anthropic은 Sonnet 5.5를 일상적인 코딩·문서 작업·빠른 반복에 맞춘 모델로 설명하고, Opus 5.5는 복잡하고 열린 문제에서 오래 판단해야 할 때 권합니다. 같은 작업이라도 범위와 실패 비용에 따라 적합한 모델이 달라집니다.
이 글은 2026년 10월 5일 확인한 Anthropic 공식 발표, 모델 문서, 마이그레이션 가이드, 시스템 카드를 기준으로 작성했습니다. 이 환경에서 두 모델을 같은 데이터와 코드로 직접 비교 실행하지 않았습니다. 아래 성능 수치는 Anthropic 및 명시된 평가 기관의 시험 결과이며, 한국어 업무와 실제 조직 환경의 결과를 보장하지 않습니다.
먼저 결론: 반복 업무는 Sonnet, 애매한 판단은 Opus
정답 형식과 완료 기준이 분명한 업무라면 Sonnet 5.5부터 시험하는 편이 합리적입니다. 버그 수정, 문서 다듬기, 슬라이드·스프레드시트 초안, 정해진 형식의 분석처럼 범위를 좁힐 수 있는 작업이 여기에 들어갑니다.
반대로 여러 이해관계와 불완전한 근거를 함께 판단해야 하거나, 조사 방향 자체를 모델이 계속 수정해야 하는 작업은 Opus 5.5가 더 적합합니다. 장기 에이전트 작업, 복잡한 설계 결정, 열린 연구, 높은 실패 비용이 있는 의사결정이 대표적입니다.
| 선택 기준 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| 주요 용도 | 잘 정의된 일상 업무, 버그 수정, 문서·슬라이드·스프레드시트 | 복잡하고 열린 문제, 장기 판단, 고난도 에이전트 작업 |
| API 입력 가격 | 100만 토큰당 2달러 | 100만 토큰당 4달러 |
| API 출력 가격 | 100만 토큰당 10달러 | 100만 토큰당 20달러 |
| 출력 속도 | Sonnet 5보다 30% 이상 빠르다는 Anthropic 측정 | 공식 모델 비교표에서 지연 시간 ‘보통’ |
| 기본 effort | Claude 앱 Medium, API High | 공식 모델 개요 기준 Medium |
| 컨텍스트·최대 출력 | 1M 컨텍스트, 최대 128K 출력 | 1M 컨텍스트, 최대 128K 출력 |
가격은 표면적인 토큰 단가입니다. 실제 작업 비용은 모델이 사용하는 토큰 수, effort 설정, 도구 호출, 재시도, 프롬프트 캐시 사용에 따라 달라집니다. Sonnet 5.5가 항상 정확히 절반의 비용으로 끝난다는 뜻은 아닙니다.
Sonnet 5.5에서 달라진 핵심
Anthropic은 2026년 9월 28일 Sonnet 5.5를 공개했습니다. 공식 발표에서 강조한 변화는 속도와 작업당 효율입니다.
- Sonnet 5보다 출력 생성 속도가 30% 이상 빠르다고 설명합니다.
- 입출력 토큰 단가는 Sonnet 5와 같지만, 같은 작업에 필요한 토큰이 줄어 작업당 비용이 최대 30% 낮아질 수 있다고 밝힙니다.
- 잘 정의된 코딩과 일반 지식 업무에서 Sonnet 5보다 크게 개선됐다고 보고합니다.
- 일부 벤치마크에서는 높은 effort의 Sonnet 5.5가 Opus 5.5와 가까운 결과를 냈지만, Anthropic은 열린 문제와 지속적 판단에서는 Opus 5.5가 여전히 더 강하다고 명시합니다.
“최대 30% 저렴”은 API 단가 인하가 아니라 Anthropic 내부 시험에서 작업을 끝내는 데 필요한 토큰이 줄었다는 주장입니다. 업무와 프롬프트가 다르면 절감 폭도 달라집니다.
벤치마크 숫자는 어떻게 읽어야 하나요?
공식 발표에는 Terminal-Bench 4.0, FrontierCode 1.1, CursorBench 4.0, GDPval-AA, OSWorld 2.1 등 다양한 결과가 포함됩니다. 이 숫자는 모델의 특정 능력을 비교하는 참고 자료이지 모든 업무의 순위를 정하는 한 줄짜리 점수가 아닙니다.
예를 들어 Sonnet 5.5는 Terminal-Bench 4.0에서 70.6%로 제시됐고, GDPval-AA에서는 Opus 5.5와 거의 같은 점수를 기록했습니다. 하지만 평가마다 effort, 도구, 실행 환경, 채점 방식이 다릅니다. Anthropic도 벤치마크가 능력의 한 측면만 포착한다고 설명합니다.
특히 FrontierCode에서는 Max effort 결과가 Xhigh보다 낮은 사례가 있었습니다. 공식 각주에 따르면 높은 effort에서 코드 리뷰 스킬과 여러 하위 에이전트를 더 자주 사용하면서 시간 초과나 범위 밖 수정이 생겨 채점상 불리해진 경우가 있었습니다. 더 오래 생각하고 도구를 더 많이 쓴다고 항상 점수가 오르는 것은 아닙니다.
업무별 선택은 이렇게 시작하세요
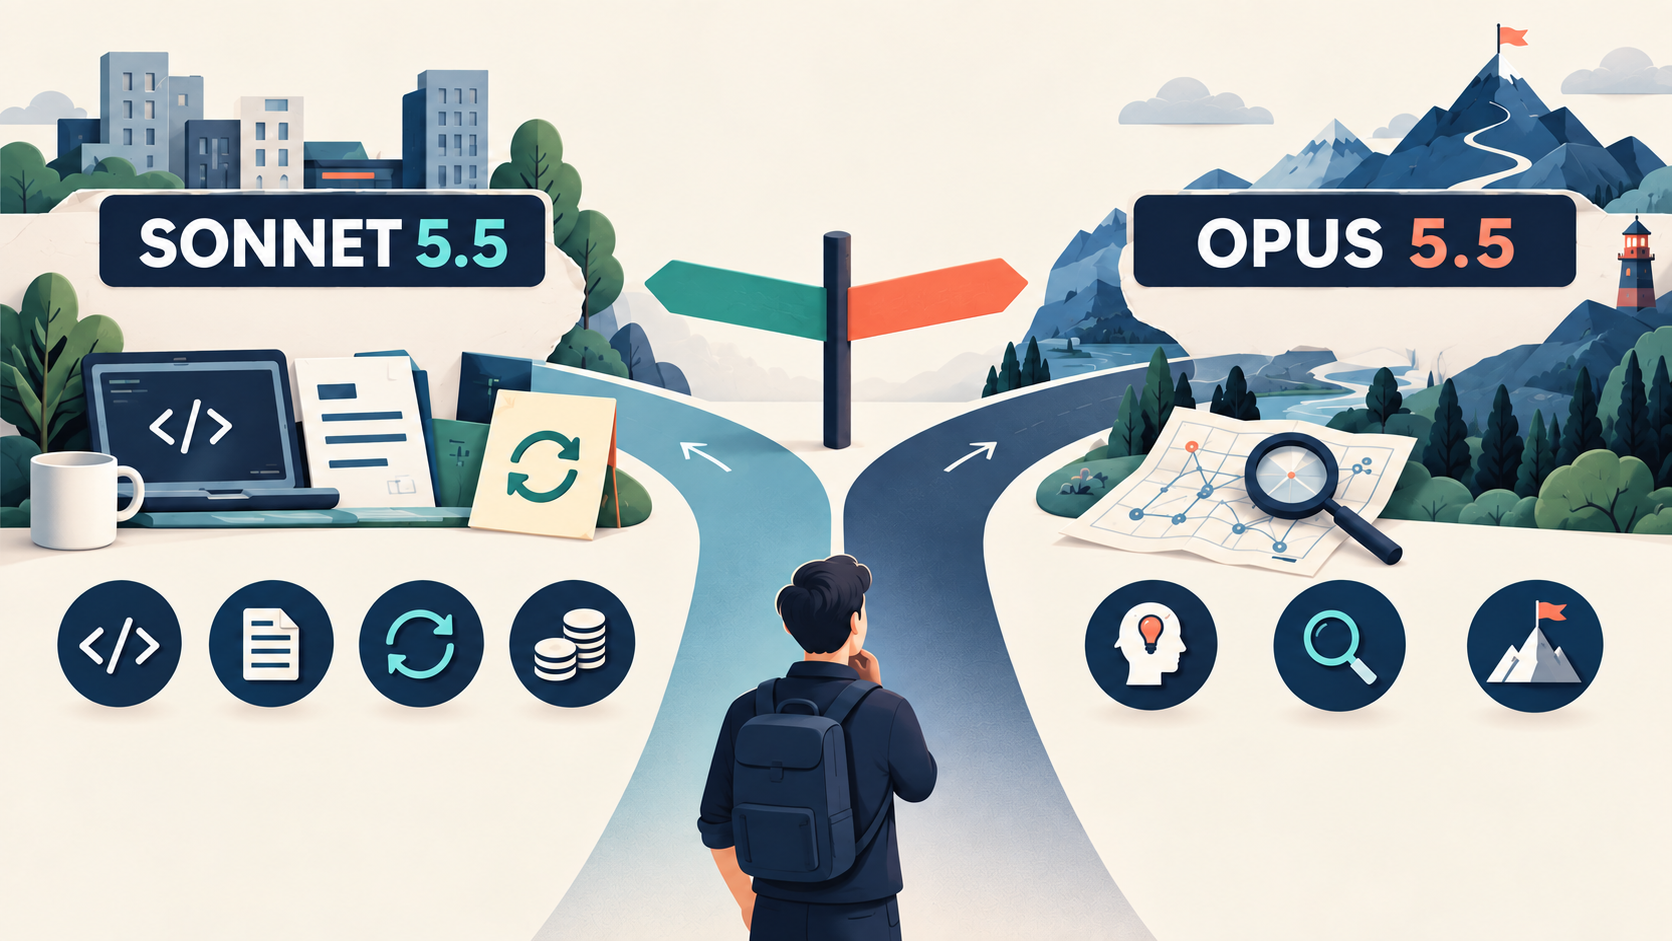
Sonnet 5.5부터 시험할 업무
- 재현 방법과 테스트가 있는 버그 수정
- 정해진 템플릿의 보고서·슬라이드·스프레드시트 초안
- 여러 문서의 형식 통일과 핵심 항목 추출
- 빠르게 여러 버전을 만들고 사람이 선택하는 디자인·문구 작업
- 대량 API 호출에서 비용과 지연 시간이 중요한 분류·변환 작업
Opus 5.5를 먼저 고려할 업무
- 요구사항이 충돌하는 시스템 설계
- 조사 중 가설과 경로를 계속 수정해야 하는 열린 분석
- 여러 도구를 오래 사용하며 판단을 누적하는 에이전트 작업
- 작은 오류도 계약·보안·운영에 큰 영향을 주는 고위험 초안
- Sonnet 5.5를 실제 평가했지만 품질 기준에 반복해서 미달한 작업
가장 안전한 운영 방식은 업무 전체를 한 모델에 고정하는 것이 아니라 단계별로 나누는 것입니다. Sonnet 5.5로 자료 정리와 초안을 빠르게 만들고, 중요한 판단이나 최종 검토만 Opus 5.5로 올릴 수 있습니다. 다만 모델 간 전달 과정에서 원문과 제약이 빠지지 않도록 같은 평가 입력을 유지해야 합니다.
비용 비교는 ‘한 번의 답변’이 아니라 ‘업무 한 건’으로 하세요
Sonnet 5.5의 공식 API 가격은 입력 100만 토큰당 2달러, 출력 100만 토큰당 10달러입니다. Opus 5.5는 입력 4달러, 출력 20달러입니다. 캐시 읽기는 둘 다 0.20달러이며, 캐시 쓰기는 Sonnet 2.50달러, Opus 5달러입니다.
실무 비용을 비교할 때는 다음 항목을 함께 기록해야 합니다.
- 최종 결과를 얻기까지의 총 입력·출력 토큰
- 도구 호출과 하위 에이전트 횟수
- 사람이 수정한 시간과 재실행 횟수
- 실패·시간 초과·범위 밖 변경 비율
- 프롬프트 캐시 적중 여부
Sonnet이 한 번에 끝내면 단가 차이가 그대로 이점이 됩니다. 반대로 복잡한 작업에서 여러 번 재시도하고 사람이 많은 부분을 고쳐야 한다면 처음부터 Opus를 쓴 편이 전체 비용이 낮을 수도 있습니다. 공식 벤치마크보다 내 업무 20~50건의 완료율과 수정량이 더 직접적인 선택 근거입니다.
effort 설정은 속도·비용·검토 깊이를 바꿉니다
Sonnet 5.5는 effort 수준으로 모델이 작업에 쓰는 계산과 검토량을 조절할 수 있습니다. Anthropic 발표에 따르면 Claude 앱과 Claude Code의 기본값은 Medium, Claude Platform의 기본값은 High입니다.
- 낮은 effort: 형식이 분명하고 반복적인 작업, 빠른 초안, 비용 민감한 대량 처리에 적합합니다.
- 중간 effort: 일반 앱 사용의 출발점입니다. 품질과 속도의 균형을 확인하기 좋습니다.
- 높은 effort: 더 오래 추론하고 검토하지만 출력 토큰과 시간이 늘 수 있습니다. 범위 밖 행동이나 시간 초과도 평가해야 합니다.
모델과 effort를 동시에 바꾸면 어느 변화가 결과에 영향을 줬는지 알기 어렵습니다. 먼저 모델을 고정해 effort를 비교하거나, effort를 고정해 Sonnet과 Opus를 비교하세요.
API 이전 때 코드가 깨질 수 있는 지점
Sonnet 5.5의 API 모델 ID는 claude-sonnet-5-5입니다. 기존 Sonnet 4.6 이하에서 옮긴다면 모델 이름만 바꾸는 것으로 끝나지 않을 수 있습니다.
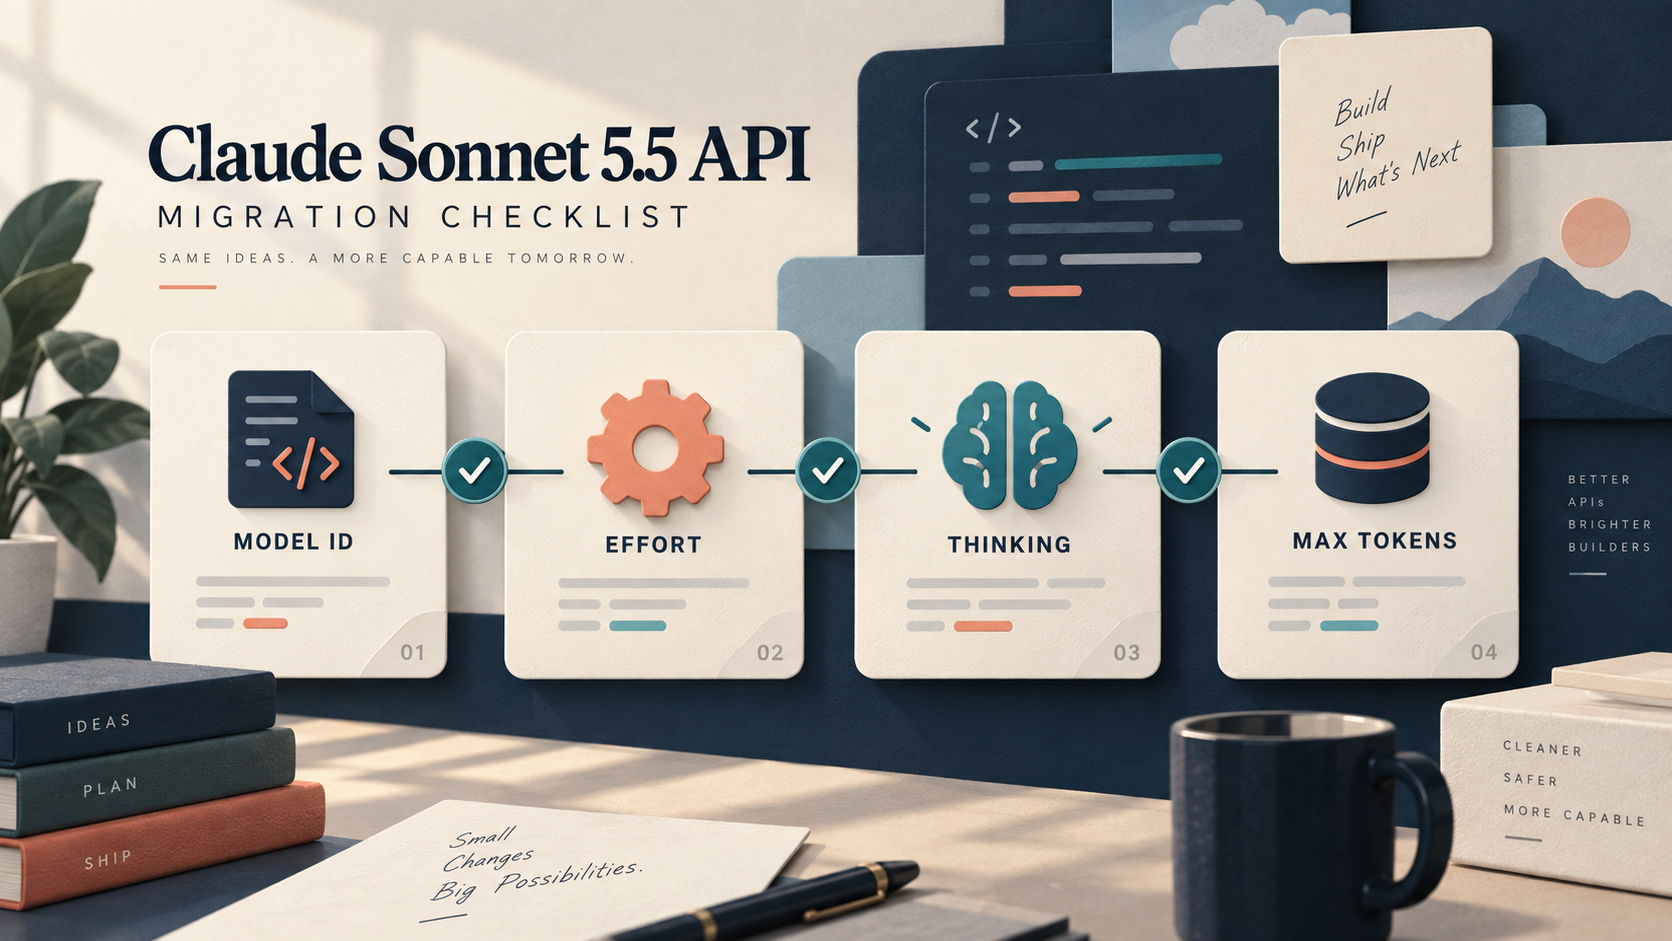
- thinking 기본 동작: Sonnet 5.5는 thinking 필드를 생략해도 adaptive thinking이 켜집니다.
- 응답 블록 처리: 응답 첫 블록이 항상 text라고 가정해
content[0].text만 읽으면 깨질 수 있습니다. block type별로 처리해야 합니다. - 도구 반복: tool-use 루프에서는 thinking 블록을 그대로 다시 전달해야 합니다.
- max_tokens: thinking과 최종 텍스트를 함께 포함하므로 기존 상한이 너무 작을 수 있습니다.
- thinking 끄기: 예전의
thinking: {"type":"disabled"}는 400 오류가 날 수 있습니다. 공식 마이그레이션 문서의between_tools방식을 확인해야 합니다. - 샘플링·도구 강제 설정: 이전 버전에서 쓰던 일부 매개변수와 강제 tool choice 조합은 변경이 필요할 수 있습니다.
공식 가이드는 모델 전환 전에 첫 두 섹션과 현재 사용 중인 모델별 변경 사항, 마지막 마이그레이션 체크리스트를 순서대로 읽도록 안내합니다. 운영 API라면 작은 트래픽부터 전환하고 400 오류, 응답 블록 파서, 토큰 비용, 도구 루프를 따로 확인해야 합니다.
보안 가드레일 때문에 결과가 달라질 수 있습니다
Sonnet 5.5는 사이버 보안 역량이 높아져 Opus 계열과 유사한 사이버 보호 장치와 fallback이 적용됩니다. 일상적인 소프트웨어 개발과 버그 수정은 계속 지원하지만, 고위험 사이버 요청은 Sonnet 5로 전환될 수 있습니다.
생물학 분야는 Sonnet 5와 같은 보호 장치를 사용합니다. Anthropic은 대부분의 연구·교육·임상 업무는 영향을 받지 않지만 일부 미생물학·바이러스학 요청이 잘못 차단될 수 있다고 명시합니다. 특정 전문 업무에서 응답이 달라졌다면 모델 성능 저하로 단정하기 전에 보호 장치와 검증 프로그램 적용 여부를 확인해야 합니다.
또한 preserved thinking이 계정에 연결되므로 계정 간 대화를 옮기거나 Claude Code 세션 도중 계정을 바꾸는 흐름은 공식 문서를 확인해야 합니다.
한국 사용자가 확인할 조건
Anthropic의 지원 지역 목록에는 South Korea가 API와 Claude.ai 모두 포함돼 있습니다. Sonnet 5.5는 Claude Platform뿐 아니라 Amazon Web Services, Google Cloud, Microsoft Azure에서도 제공됩니다. Claude 앱에서 보이는 모델과 API에서 호출하는 모델, 클라우드 사업자를 통해 쓰는 모델은 결제·권한·데이터 정책이 다를 수 있으므로 구분해야 합니다.
개인 Claude Pro는 월 결제 20달러, 연간 결제 시 월 환산 17달러로 안내됩니다. Max는 월 100달러부터입니다. 다만 구독 요금과 API 종량제는 별도입니다. Claude 구독을 결제했다고 API 토큰 사용료가 모두 포함되는 것으로 이해하면 안 됩니다.
실제 선택을 위한 5단계 평가법
- 자주 하는 업무 20~50건을 익명화해 평가 세트를 만듭니다.
- 입력, 도구, effort, 완료 기준을 같게 맞춥니다.
- Sonnet 5.5와 Opus 5.5의 성공률, 총 토큰, 지연 시간, 수정 시간을 기록합니다.
- 단순 평균 대신 오류 유형을 나눕니다. 사실 오류, 누락, 범위 밖 수정, 형식 실패를 따로 봅니다.
- 일상 업무는 비용 대비 기준으로, 고위험 업무는 실패 비용까지 포함해 선택합니다.
Sonnet 5.5는 빠르고 저렴한 출발점이지만 모든 작업에서 Opus를 대체하는 모델은 아닙니다. 업무 범위를 명확히 할 수 있고 반복 실행이 많다면 Sonnet의 이점이 큽니다. 요구가 계속 바뀌거나 판단 실패의 비용이 크다면 Opus를 유지하거나 최종 검토 단계에 배치하는 편이 낫습니다.
자주 묻는 질문
Sonnet 5.5가 Opus 5.5보다 성능이 좋은가요?
일부 코딩 평가에서는 Sonnet 5.5가 높은 점수를 냈지만 모든 업무에서 우위라는 뜻은 아닙니다. Anthropic은 복잡하고 열린 판단에서는 Opus 5.5가 더 강하다고 설명합니다.
가격이 정확히 절반인가요?
공식 API의 입력·출력 토큰 단가는 Sonnet 5.5가 Opus 5.5의 절반입니다. 실제 업무 비용은 토큰 수, effort, 재시도, 도구 호출, 캐시 사용에 따라 달라집니다.
한국에서도 API를 사용할 수 있나요?
Anthropic의 공식 지원 지역 목록에 South Korea가 포함돼 있습니다. 실제 이용은 계정, 결제, 조직 정책, 선택한 클라우드 사업자의 조건도 확인해야 합니다.
Sonnet 5에서 모델 ID만 바꾸면 되나요?
항상 그렇지는 않습니다. thinking 블록 처리, max_tokens, 일부 매개변수와 tool-use 코드가 영향을 받을 수 있으므로 공식 마이그레이션 가이드를 확인해야 합니다.
출처 및 확인일
- Anthropic, “Introducing Claude Sonnet 5.5”, 2026-09-28, https://www.anthropic.com/claude-sonnet-5-5, 확인일 2026-10-05.
- Anthropic, “Claude Sonnet 5.5 System Card”, 2026-09, https://www.anthropic.com/claude-sonnet-5-5-system-card, 확인일 2026-10-05.
- Anthropic, “Models overview”, 게시·업데이트 절대 날짜 미표기, https://platform.claude.com/docs/en/about-claude/models/overview, 확인일 2026-10-05.
- Anthropic, “Migrating to Claude Sonnet 5.5”, 게시·업데이트 절대 날짜 미표기, https://platform.claude.com/docs/en/models/sonnet-5-5/migration-guide, 확인일 2026-10-05.
- Anthropic, “Supported countries & regions”, 게시·업데이트 절대 날짜 미표기, https://www.anthropic.com/supported-countries, 확인일 2026-10-05.
'💻IT' 카테고리의 다른 글
| Claude Code Mods 사용 전 확인할 것: 플러그인 권한·보안 체크리스트 (0) | 2026.10.07 |
|---|---|
| GPT-6 프롬프트 캐싱 사용법: 긴 에이전트 작업의 API 비용 줄이기 (0) | 2026.10.07 |
| ChatGPT dots 설정법: 상시 에이전트에 맡기기 전 권한 체크리스트 (0) | 2026.10.06 |
| Codex CLI 음성·병렬 에이전트, 권한부터 잡는 운영 가이드 (0) | 2026.10.05 |
| ChatGPT 가상 피팅 써도 될까? 사진 삭제·핏 확인 체크리스트 (0) | 2026.10.05 |

