AI 코딩 도구가 “완료했습니다”라고 말해도, 요구사항을 충족했다는 뜻은 아닙니다. 먼저 변경 범위를 보고, 같은 증상을 다시 확인하고, 테스트가 무엇을 검사했는지 읽은 뒤 실제 화면과 독립 리뷰까지 통과시켜야 합니다.
이 글은 Claude Code·Codex·GitHub Copilot으로 코드를 수정하는 초급·중급 사용자를 위한 검증 순서입니다. 2026년 10월 10일 기준 공식 문서를 검토했으며, 아래 명령은 실행 결과가 아니라 프로젝트에 맞게 골라 쓰는 예시입니다.
완료 보고와 완료 증거를 분리하세요
에이전트의 요약은 작업 기록이지 검수 결과가 아닙니다. “파일 3개를 수정했고 테스트가 통과했다”는 문장이 있어도 예상하지 않은 설정 파일을 건드렸거나, 테스트 자체를 느슨하게 바꿨거나, 실제 브라우저에서는 버튼이 작동하지 않을 수 있습니다.
| 확인 대상 | 묻는 질문 | 남겨야 할 증거 |
|---|---|---|
| 요구사항 | 원래 해결하려던 문제가 사라졌나 | 수정 전·후 같은 재현 절차 |
| 변경 범위 | 예상 밖 파일이 바뀌지 않았나 | git status, git diff |
| 자동 검사 | 관련 테스트·린트·빌드가 실제 실행됐나 | 실행 명령, 종료 코드, 실패 로그 |
| 테스트 품질 | 테스트를 약하게 만들어 통과시킨 것은 아닌가 | 테스트 diff와 assertion |
| 실제 동작 | 사용자 경로·권한·예외에서도 맞게 움직이나 | 브라우저·앱·통합 환경 확인 |
Anthropic의 Verification skills도 테스트 실행만으로 끝내지 말고 diff를 읽어 테스트가 약해지지 않았는지 확인하라고 설명합니다.
1단계: 요구사항을 검증 가능한 문장으로 바꾸기
“로그인 버그 수정”처럼 넓은 요청은 완료 판정도 모호합니다. 작업을 맡기기 전에 다음 다섯 줄을 적으면 검증 기준이 생깁니다.
- 정상 조건: 올바른 계정으로 로그인하면 대시보드로 이동한다.
- 실패 조건: 잘못된 비밀번호에는 오류 문구가 보이고 세션은 생기지 않는다.
- 유지 조건: 기존 소셜 로그인과 API 응답 형식은 바꾸지 않는다.
- 변경 범위: 인증 처리와 관련 테스트만 수정한다.
- 완료 증거: 재현 절차, 관련 테스트, 빌드, 실제 화면을 확인한다.
OpenAI의 Codex 워크플로 문서도 버그 수정 전에 재현 절차를 주고, 수정 뒤 같은 절차와 가장 작은 관련 테스트를 다시 실행하도록 권합니다. 공통 검증 규칙을 프로젝트 지침에 둘 때는 AGENTS.md와 CLAUDE.md의 적용 차이도 함께 확인해야 합니다.
2단계: 요약보다 먼저 실제 diff 보기
검수는 에이전트의 설명이 아니라 저장소 상태에서 시작합니다. Git 프로젝트라면 다음 명령으로 범위를 좁힙니다.
git status --short
git diff --name-only
git diff --stat
git diff -- path/to/file
예상한 파일이 빠졌는지, 관련 없는 설정·잠금 파일·비밀정보·빌드 산출물이 섞였는지 봅니다. 삭제와 이름 변경도 놓치기 쉬우므로 파일 수만 보지 말고 목록을 읽으세요. 수정됐는데 편집기에 보이지 않는다면 같은 작업 폴더와 Git 상태부터 보는 파일 변경 진단 순서가 먼저입니다.
3단계: 같은 재현 절차와 가장 작은 테스트 실행
버그 수정은 “테스트 통과”보다 수정 전 실패하던 행동이 수정 후 성공했는지가 먼저입니다. 가능하면 수정 전 증상을 기록하고, 수정 뒤 같은 입력·계정·경로로 다시 확인하세요.
# 실제 프로젝트에 존재하는 명령만 선택
npm run lint
npm test
npm run build
명령 이름을 추측하지 말고 package.json, README, CI 설정에서 실제 스크립트를 확인합니다. 작은 관련 테스트가 통과하면 전체 회귀 테스트로 넓히되, 실패를 시간 부족으로 숨기지 말고 “무엇이 실패했고 이번 변경과 관련 있는지”를 분리해 기록합니다.
4단계: 테스트가 실제 요구사항을 검사하는지 읽기
초록색 결과만으로는 부족합니다. 에이전트가 테스트를 새로 만들거나 수정했다면 아래 항목을 확인하세요.
- assertion이 실제 출력·상태 변화를 비교하는가
- 예외가 나지 않는지만 보고 성공 처리하지 않는가
- 외부 서비스와 DB를 전부 mock해 통합 오류를 가리지 않는가
- 빈 값·권한 없음·네트워크 실패·중복 요청이 빠지지 않았는가
- 기존 테스트를 삭제하거나 조건을 느슨하게 바꾸지 않았는가
Anthropic의 검증 루프 가이드는 타입 검사·린터·테스트·런타임 오류를 반복 루프에 넣되, 자동으로 알 수 없는 UI와 기능은 별도 수동 검증으로 남겨야 한다고 설명합니다.
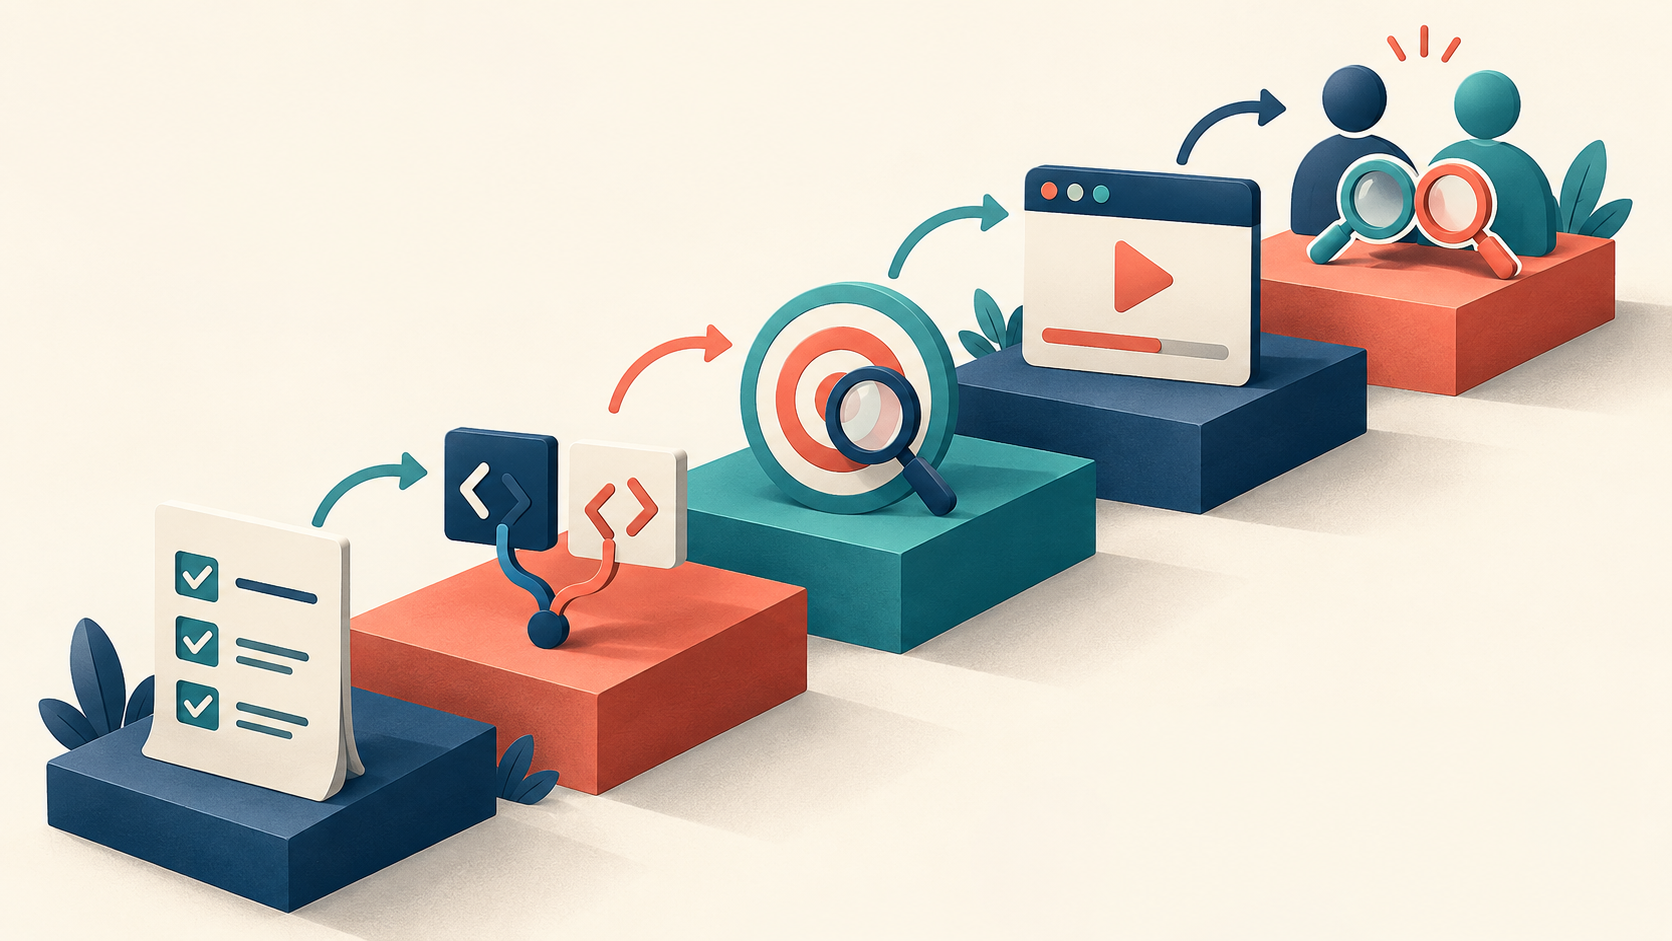
5단계: 실제 동작과 독립 리뷰로 마감하기
웹 화면이라면 브라우저에서 정상 경로와 실패 경로를 눌러 보고, API라면 실제 요청·응답과 권한을 확인합니다. 린터와 단위 테스트는 반응형 레이아웃, 잘못된 리디렉션, 쿠키·권한 문제를 잡지 못할 수 있습니다.
중요한 변경은 작성 세션과 분리한 두 번째 검토를 붙이세요. Codex의 /review, GitHub Copilot 코드 리뷰, Claude Code의 검증 Skill을 활용할 수 있습니다. 다만 GitHub 공식 문서처럼 AI 리뷰는 기본적으로 사람의 필수 승인과 같지 않습니다. 깨끗한 리뷰도 안전 보장이 아니라 한 겹의 방어입니다.
막힐 때는 실패 종류부터 나누세요
| 상태 | 다음 행동 |
|---|---|
| 명령이 없음 | README·CI·패키지 스크립트에서 실제 명령 확인 |
| 테스트 환경이 없음 | 실행하지 못한 범위를 명시하고 수동 재현·diff 검토 강화 |
| 관련 없는 테스트가 실패 | 기존 실패인지 이번 변경 영향인지 재현해 분리 |
| UI 확인이 불가 | 검증 완료로 처리하지 말고 실행 가능한 환경에서 확인 |
| AI 리뷰가 문제없다고 함 | 요구사항·diff·실행 증거를 사람이 다시 대조 |
완료의 기준은 “AI가 자신 있게 말했는가”가 아니라 요구사항마다 확인 가능한 증거가 남았는가입니다. 작은 작업도 변경 종류에 따라 UI·권한 검증이 더 필요할 수 있습니다. 특히 권한·결제·배포처럼 실패 비용이 큰 작업은 실제 환경과 독립 리뷰까지 검증 범위를 넓히세요.
출처 및 확인일
- OpenAI, 「Prompting overview / Codex workflows」, 게시일 미표기, https://developers.openai.com/codex/workflows, 확인 2026-10-10
- OpenAI Alignment Research, 「A Practical Approach to Verifying Code at Scale」, 2025-12-01, https://alignment.openai.com/scaling-code-verification/, 확인 2026-10-10
- Anthropic, 「Verification skills」, 게시일 미표기, https://academy.claude.com/courses/claude-code-in-action/verification-skills, 확인 2026-10-10
- Anthropic, 「Building verification loops in Claude Code with skills」, 게시일 미표기, https://claude.com/blog/building-verification-loops-in-claude-code-with-skills, 확인 2026-10-10
- GitHub, 「Using GitHub Copilot code review」, 게시일 미표기, https://docs.github.com/en/copilot/using-github-copilot/code-review/using-copilot-code-review, 확인 2026-10-10
'💻IT' 카테고리의 다른 글
| Claude Code 어제 작업 이어가기: 긴 대화는 계속할까, 새로 열까? (0) | 2026.10.12 |
|---|---|
| Claude Dashboards·Motion, 연결만 하면 끝일까? 플랜·권한·검증 기준 (0) | 2026.10.11 |
| Nano Banana 2.1, 1K는 반값인데 4K는 왜 다를까? 비용·검수 기준 (0) | 2026.10.10 |
| AGENTS.md와 CLAUDE.md를 둘 다 만들면 끝일까? Claude가 하나를 건너뛰는 조건 (0) | 2026.10.10 |
| GPT-6 Intelligent UI 사용법: 화면보다 출처와 계산식을 확인하는 법 (0) | 2026.10.09 |

